
Intelligenza artificiale nei controlli fiscali e diritti dei contribuenti
Nell’impossibilità di controllare tutti i contribuenti, le amministrazioni tributarie ricercano costantemente metodi efficaci per monitorare l’inadempimento e selezionare i contribuenti da sottoporre a controllo. In alternativa alla selezione casuale, hanno sperimentato selezioni annuali di specifiche categorie di contribuenti, parametri e statistiche e, più di recente, metodi di analisi del rischio basati sull’IA.
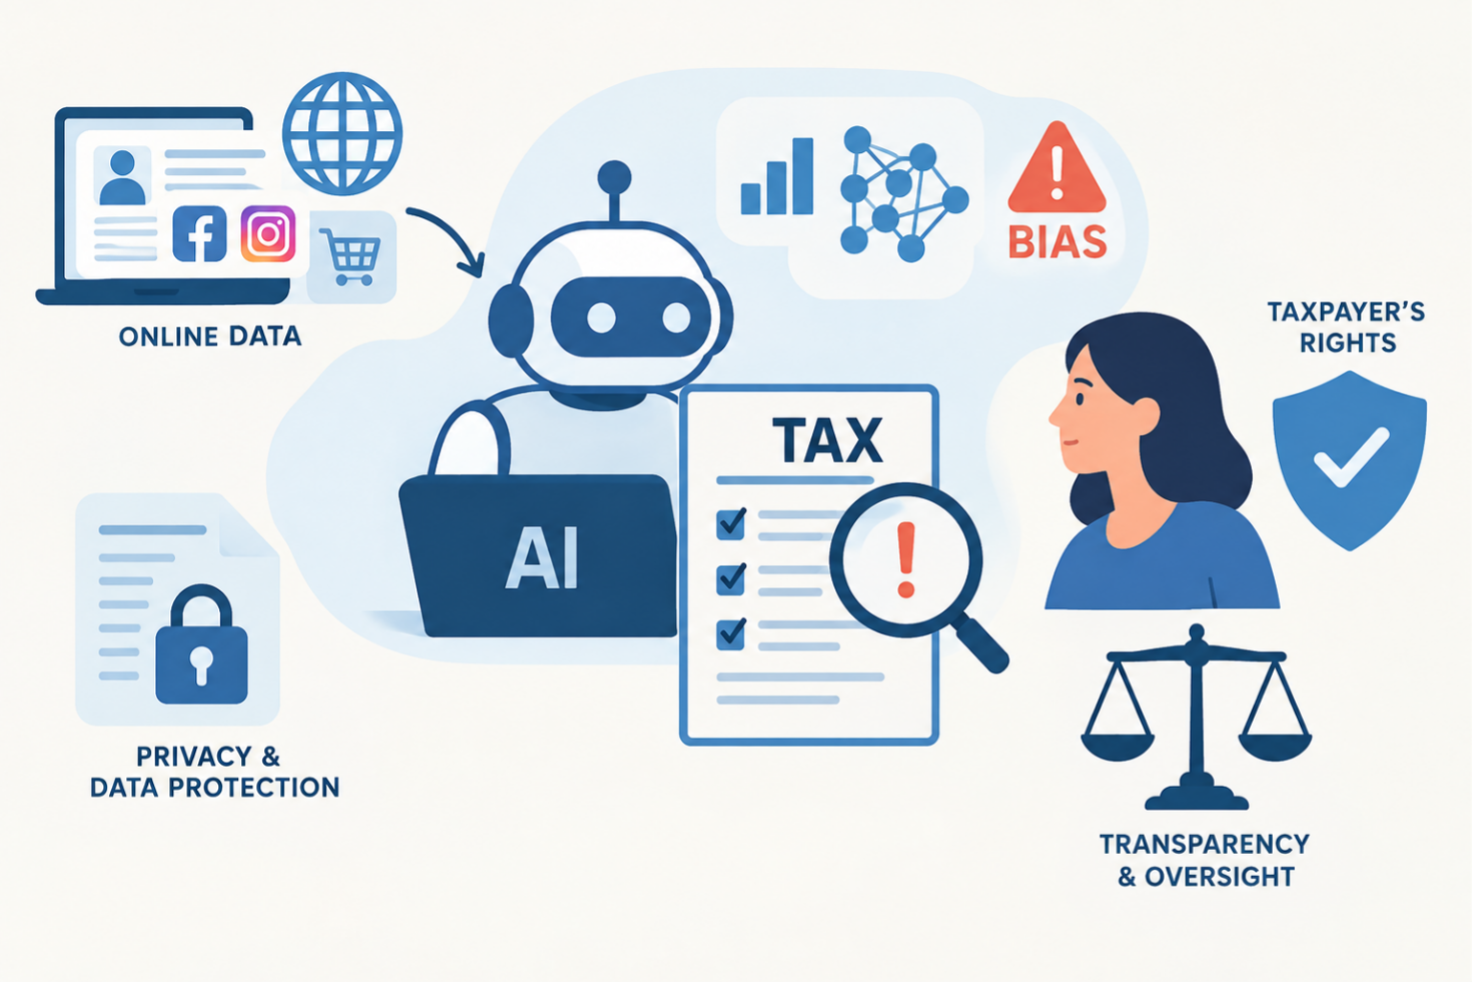
La Francia offre un esempio di impiego del “web scraping” a fini di controllo fiscale. La Commissione nazionale per l’informatica e le libertà e il Conseil constitutionnel hanno contribuito a definire un quadro a tutela della riservatezza e della libertà di espressione: lo strumento può raccogliere soltanto dati riguardanti violazioni deliberate o strategie fraudolente che abbiano determinato una sottostima o un occultamento di ricavi e le informazioni raccolte non possono da sole fondare un recupero d’imposta.
L’impiego del machine learning nei controlli fiscali pone anzitutto una questione di legalità. Statistici ed esperti di IA hanno evidenziato il compromesso tra accuratezza predittiva e interpretabilità dei modelli. Gli alberi decisionali sono di facile interpretazione, poiché ogni passaggio può essere descritto con una regola “se-allora”, ma non sono paragonabili ai migliori approcci di apprendimento supervisionato in termini di accuratezza. Le reti neurali, specie se si ricorre al deep learning, tendono ad apprendere e riproporre “scatole nere”: non è possibile individuare una regola che colleghi l’output all’input. La mancanza di trasparenza ostacola sia la capacità dei funzionari pubblici di esercitare una sostanziale sorveglianza sul sistema, sia quella del destinatario della decisione di comprenderne la logica. Ci si può chiedere se tali risultanze siano sufficientemente interpretabili affinché i contribuenti accettino di correggere gli errori e i funzionari possano condurre un controllo più approfondito senza timore di contraddire l’IA. In assenza di un’adeguata sorveglianza umana, possono risultare compromessi l’obbligo di motivazione e, in ultima analisi, il diritto di difesa del contribuente.
Quanto all’equità, l’IA è spesso apprezzata per la sua neutralità, poiché sembra in grado di eludere i pregiudizi umani. Tuttavia, può condurre a discriminazioni derivanti da dati o addestramento distorti, con una portata potenzialmente massiva rispetto ai pregiudizi umani. Il machine learning individua correlazioni, non nessi causali, e talvolta le correlazioni possono essere casuali o basate su caratteristiche irrilevanti. Le tecniche non supervisionate evitano risultati distorti dovuti a un addestramento distorto, non essendovi alcun supervisore, ma non prevengono risultati distorti dovuti a dati distorti, mentre gli alberi decisionali sono fortemente esposti ai pregiudizi. La capacità dell’IA di decidere in un istante può amplificare l’impatto di tali bias, dando luogo a migliaia di decisioni errate.
È quanto accaduto nei Paesi Bassi, dove nel 2021 il Governo si è dimesso a causa dello scandalo dei sussidi per l’infanzia. Secondo un’inchiesta parlamentare, il sistema algoritmico classificava erroneamente i genitori stranieri come beneficiari non idonei, presumibilmente perché addestrato su precedenti accertamenti di frode riguardanti persone straniere. Poiché la cittadinanza olandese non era richiesta per percepire il sussidio, tale caratteristica avrebbe dovuto essere esclusa dai dati di addestramento. Sono stati invece emessi migliaia di ordini di recupero errati, con gravi conseguenze economiche e personali per le famiglie coinvolte, a causa di un addestramento carente del sistema di gestione del rischio e di una supervisione umana insufficiente. Preoccupazioni analoghe emergono negli Stati Uniti, dove studi recenti mostrano che, nonostante il calo complessivo dei controlli dovuto ai tagli di bilancio, i contribuenti a basso reddito, spesso provenienti da contee a maggioranza non bianca, hanno una probabilità di essere controllati molto superiore. La distorsione regionale dell’IRS rivela una distorsione non intenzionale, con ogni probabilità dovuta alla semplicità e all’economicità dei controlli sul credito d’imposta per i redditi da lavoro dei contribuenti minori. Poiché gli algoritmi di autoapprendimento apprendono dal passato, la selezione dei contribuenti da controllare affidata all’IA può solo aggravare tali esiti, perpetuando modelli storici di discriminazione.
Nemmeno il Regolamento UE sull’IA sembra affrontare tali questioni. Esso riconosce il rischio di discriminazione per le attività di credit scoring, poiché può perpetuare modelli storici di discriminazione, e impone ai sistemi ad alto rischio requisiti di elevata qualità dei dati, trasparenza, sorveglianza umana, precisione e robustezza. Tuttavia, i sistemi di IA impiegati da autorità fiscali e doganali non sono classificati come ad alto rischio. Il presupposto sembra essere che i diritti in gioco nei procedimenti tributari siano meno significativi, il che non è sempre vero: il sistema dell’imposta sul reddito è utilizzato anche per redistribuire la ricchezza e i contribuenti che si trovano in una posizione vulnerabile non dovrebbero essere esclusi dalle nuove tutele introdotte dal Regolamento.
Secondo la giurisprudenza di diversi Paesi europei, quando le pubbliche amministrazioni si affidano a strumenti decisionali automatizzati dovrebbero essere garantiti pricipalmente tre diritti: il diritto alla trasparenza algoritmica, il diritto all’intervento umano e il diritto alla protezione contro le discriminazioni. Tali diritti sono desunti principalmente dal diritto alla vita privata sancito dalla Convenzione europea dei diritti dell’uomo e dalla Carta dei diritti fondamentali dell’UE e sono ulteriormente sviluppati dal GDPR, che riconosce il diritto di essere informati dell’esistenza di un processo decisionale automatizzato, compresa la profilazione, e il diritto di non essere sottoposti a una decisione basata unicamente su tali tecniche. Tuttavia, il GDPR consente agli Stati membri di limitare tali diritti per salvaguardare obiettivi di interesse pubblico generale, tra cui la materia tributaria. Il principio di segretezza fiscale, che impedisce fenomeni di ingegneria inversa dei controlli, è difficilmente conciliabile con il principio di trasparenza algoritmica. Se tale limitazione è ragionevole, altre restrizioni dovrebbero essere evitate o riconsiderate, come le limitazioni ai diritti di accesso e rettifica dei dati personali detenuti dalle autorità fiscali e al diritto di rifiutare decisioni fiscali interamente automatizzate.
In forza dell’obbligo di motivazione, gli avvisi di accertamento derivanti da tecniche decisionali automatizzate dovrebbero essere confermati solo se la motivazione è interpretabile e coerente con le pertinenti disposizioni tributarie. Ai contribuenti dovrebbe sempre essere garantito il diritto al contraddittorio. La capacità degli algoritmi di autoapprendimento di estrarre conoscenza dai dati può inoltre suggerire nuove presunzioni, la cui ratio merita un’attenta valutazione prima di ammetterle a fini accertativi. Un livello accettabile di tutela potrebbe essere negoziato nell’ambito delle modifiche al Regolamento UE sull’IA, oppure perseguito attraverso modifiche agli Statuti dei diritti del contribuente esistenti o mediante l’approvazione di Carte del contribuente per il governo digitale (Digital Government Taxpayer’s Charters).
(Focus a cura di Chiara Francioso)
Bibliografia essenziale:
ABREU, Racial issues in tax law: identification, redress, and a new vision of horizontal equity, in PARADA (Ed.), A Research Agenda for Tax Law, Cheltenham-Northampton, Elgar, 2022, 110
AMNESTY INTERNATIONAL, Xenophobic Machines. Discrimination Through Unregulated Use of Algorithms in the Dutch Childcare Benefits Scandal, London, Amnesty International Ltd, 2021, 26.
BLOOMQUIST, Regional Bias in IRS Audit Selection, in Tax Notes, March 4, 2019.
CONTRINO, Digitalizzazione dell’amministrazione finanziaria e attuazione del rapporto tributario: questioni aperte e ipotesi di lavoro nella prospettiva dei princìpi generali, in Riv. dir. trib., 2023, I, 124.
DE LA FERIA-GRAU RUIZ, The Robotisation of Tax Administration, in GRAU RUIZ (ed.), Interactive Robotics: Legal, Ethical, Social and Economic Aspects, Cham, Springer, 2022, § III.
FASOLA, L’amministrazione algoritmica dei tributi, Giuffrè, Milano, 20253, 84 et seq.
FRANCIOSO, Automated decision making by tax authorities and the protection of taxpayers’ rights in a comparative perspective, PEDRINI (Ed.), Law in the Age of Digitalization, Aranzadi, Madrid, 2024, 221.
GUIDARA, Accertamento dei tributi e intelligenza artificiale: prime riflessioni per una visione di sistema, in Dir. prat. trib., 2023, 414.
HADWICK-LAN, Lessons to Be Learned from the Dutch Childcare Allowance Scandal: a Comparative Review of Algorithmic Governance by Tax Administrations in the Netherlands, France and Germany, in World Tax J., 2021, 609 et seq.
HOFFMAN-BLOOMQUIST, A Closer Look At IRS Tax Audit Selection Bias, in Forbes, January 19, 2021.
JAMES et al., An Introduction to Statistical Learning, Springer, New York-Heidelberg-Dordrecht-London, 2013, 24.
KUŹNIACKI et al., Towards eXplainable Artificial Intelligence (XAI) in Tax Law: The Need for a Minimum Legal Standard, in World Tax J., 2022, 573.
MONTANARI-GIORGI, Digital Government Taxpayer’s Charter, in ANTÓN ANTÓN-GARCÍA HERRERA BLANCO (Eds.), Digital transformation of tax administrations in the European Union, IEF, Madrid, 2023, 279.
PAPARELLA, Brevi note sulla recente disciplina in materia di intelligenza artificiale nella prospettiva dell’attuazione del tributo, in Riv. tel. dir. trib., September 22, 2026.
PONTILLO, Algoritmi fiscali tra efficienza e discriminazione, in Riv. trim. dir. trib., 2023, 649.
RAGUCCI, L’analisi del rischio di evasione in base ai dati dell’archivio dei rapporti con gli intermediari finanziari: prove generali dell’accertamento "algoritmico"?, in Riv. tel. dir. trib., September 4, 2019.
SARTORI, I limiti probatori nel processo tributario, Giappichelli, Torino, 2023, 74.
TRESCHER, France’s approach to artificial intelligence by the French tax system, Studi Tributari Europei, 2024, I.5.